HTML
RESULT
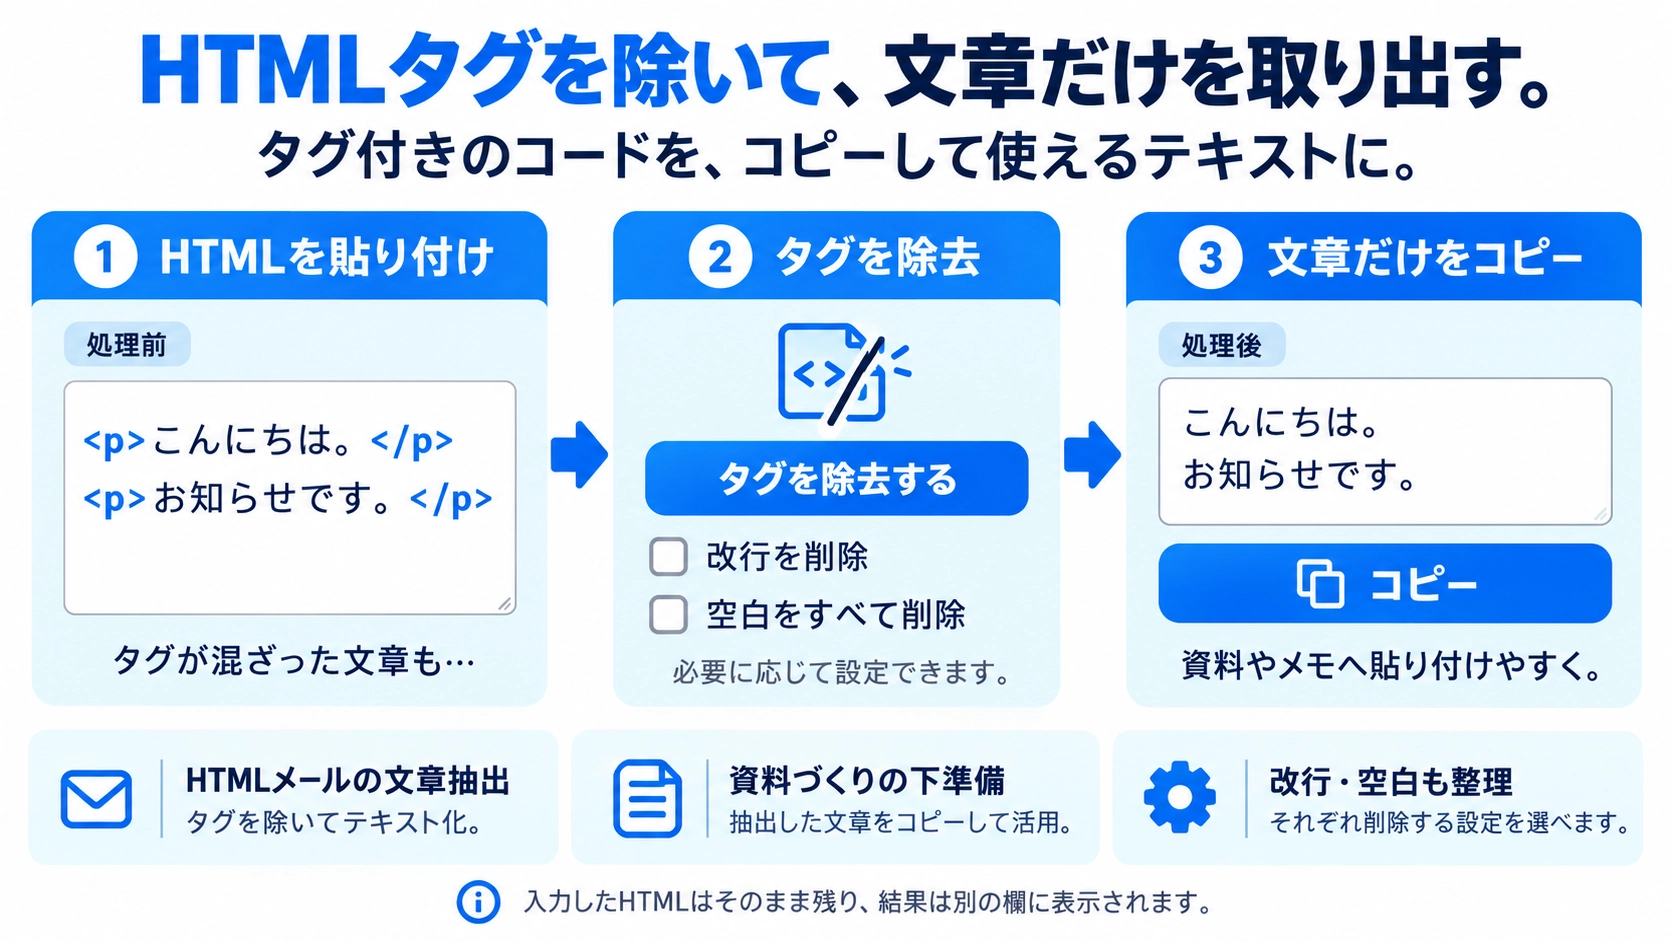
HTMLからテキストだけを抽出します。
HTMLコードからタグをすべて除去してプレーンテキストを抽出できる無料ツール。WebページのソースやメールHTMLから本文テキストだけを取り出せます。
レイアウト用の改行や空白は元のHTML構造に左右されます。必要に応じて抽出後に改行・空白整理ツールを併用してください。
Webページの本文抽出、HTMLメールから文章だけを取り出したいとき、リサーチ資料の下処理に役立ちます。
入力したHTMLをブラウザ上でHTMLとして読み込み、要素内のテキストを取り出します。HTMLコードから文章部分だけを抜き出したいときに使えます。
br、p、div、li、h1〜h6、trの区切りをいったん改行へ変換してからテキストを取り出します。
設定を何も選ばない場合は、この改行を残しながら、各行の前後にある半角スペースやタブ、空行を整理します。
「改行を削除」をONにすると、改行だけを取り除いてテキストをつなげます。元からある半角スペースやタブはそのまま残し、新しいスペースは追加しません。
「空白をすべて削除」をONにすると、半角スペース・全角スペース・タブを削除します。改行は残るため、行の区切りを保ったまま空白だけを取り除けます。
処理結果は別の結果欄へ表示され、入力したHTMLコードはそのまま残ります。抽出したテキストだけをコピーして利用できます。
はい。「改行を削除」だけをONにすると、半角スペースなどは残したまま改行だけを削除します。
はい。「空白をすべて削除」だけをONにすると、半角・全角スペースやタブを削除し、改行は残します。
はい。2つの設定を同時にONにすると、空白と改行の両方を削除できます。